田野 Ye Tian
tytian@outlook.com Google Scholar LinkedIn
我目前担任 Noitom Robotics 基础模型负责人,主导 VLM、VLA 和世界模型的预训练、后训练及 Scaling 研究。
此前,我在腾讯 Robotics X 负责具身上层模型(S2)与 Agent 团队,并兼任福田实验室(具身智能广东省实验室)具身人机交互研究中心负责人。更早之前,我在腾讯 AI Lab 从事混元基础模型的后训练与强化学习,以及腾讯绝艺的超大规模自博弈强化学习研究,也曾在 Google 与 Johnson & Johnson 合资的 Verb Surgical(Mountain View, CA)从事视频理解与生成研究。
我的研究兴趣包括具身基础模型的预训练、Scaling 与泛化,强化学习,以及语言模型的推理与自我提升。
我在约翰斯·霍普金斯大学(JHU)获得机器人学硕士学位,本科毕业于北京交大。曾在马里兰大学巴尔的摩分校(UMB)担任访问学者,并在加州大学圣迭戈分校(UCSD)交换。
当前工作
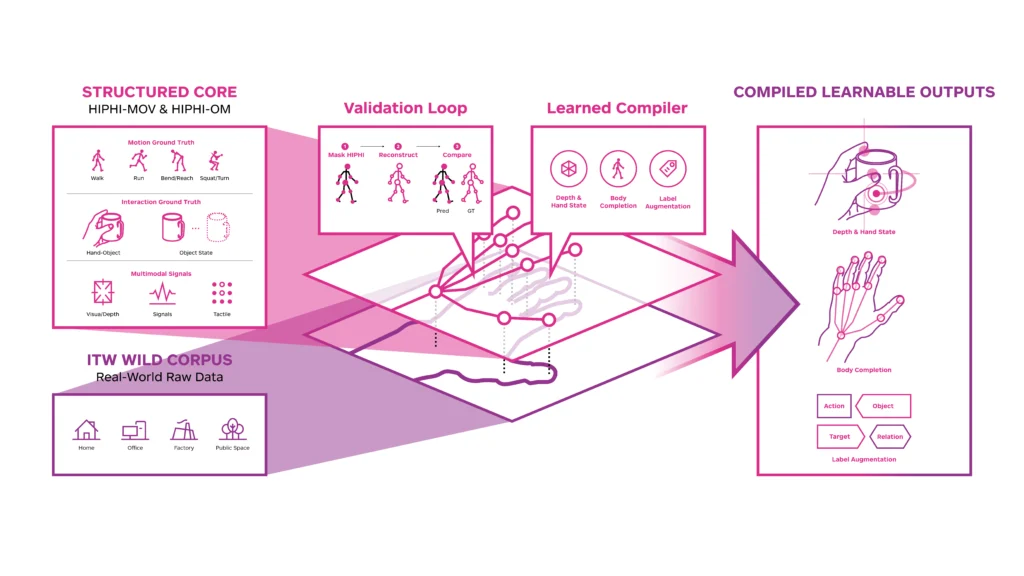
Noitom Robotics · The Information 50 2026 亚洲榜首
将具身模型预训练扩展至十万小时以上的人类行为数据,重点研究数据规模与组成、动作表示和训练方法对机器人操作能力及泛化的影响。
构建 Ego 视频的动作与语义标注管线,为具身基础模型的大规模预训练提供数据支持。
过往工作
-
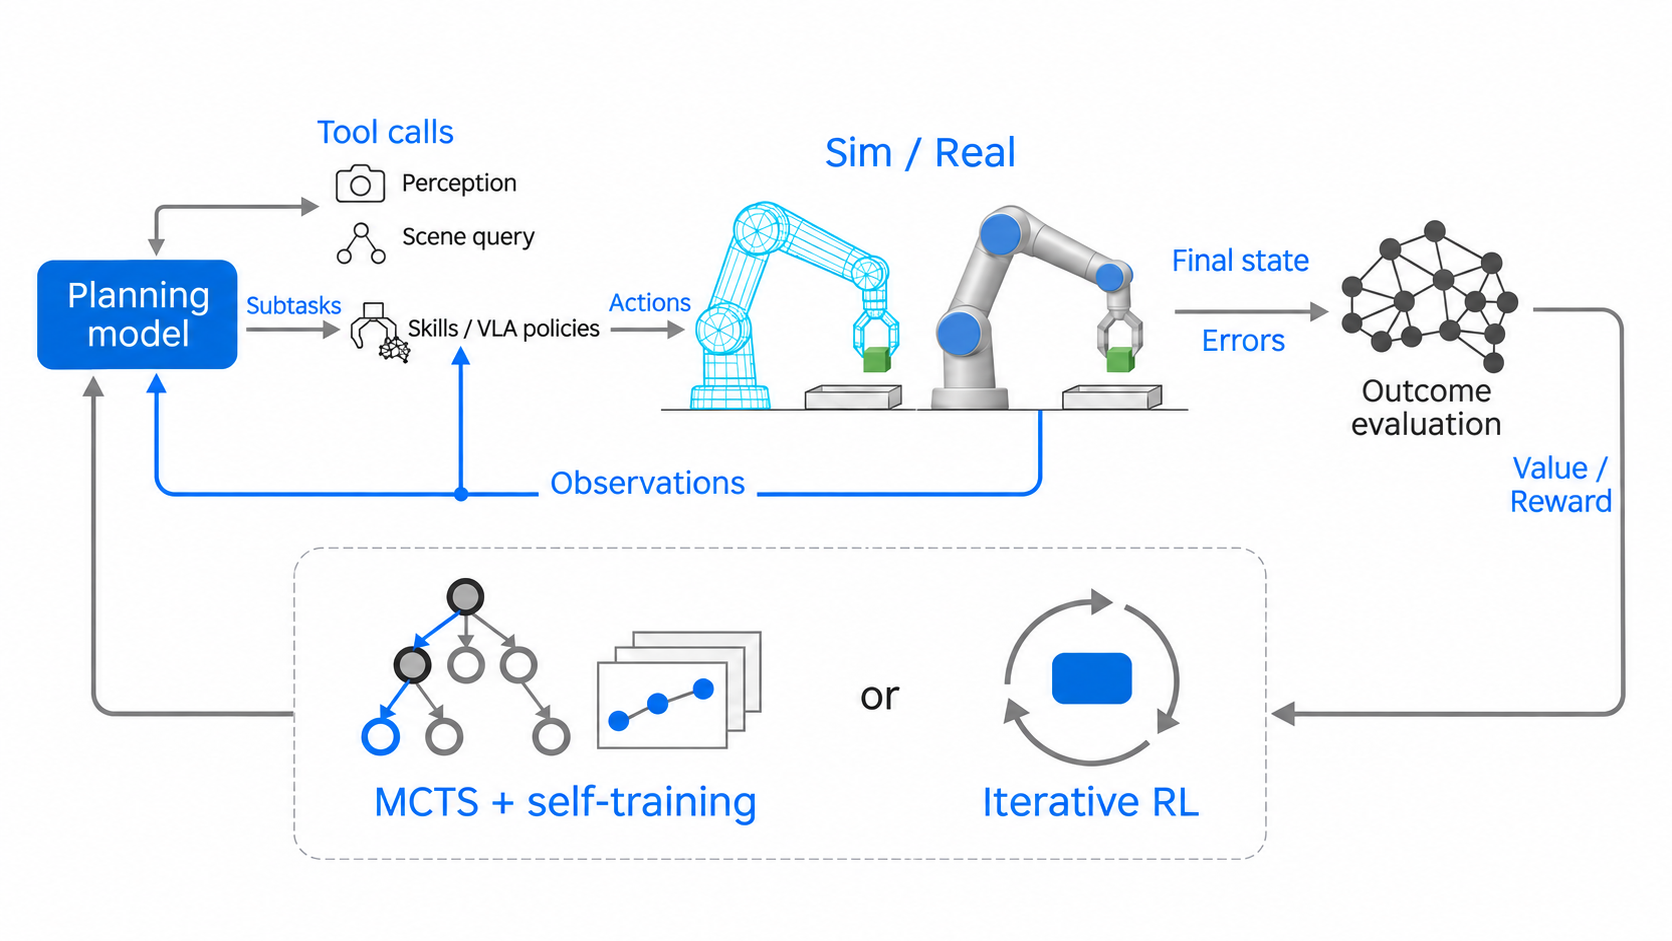
TAIROS:具身规划大模型
Tencent Robotics X
TAIROS 规划大模型面向长程机器人任务,支持复杂推理、任务分解、工具调用与多轮交互。相关研究结合 RL 与 MCTS,探索具身 Agent 的规划与决策能力。规划大模型于 WAIC 2025 展示,并通过腾讯–宇树战略合作接入宇树平台。
-
-
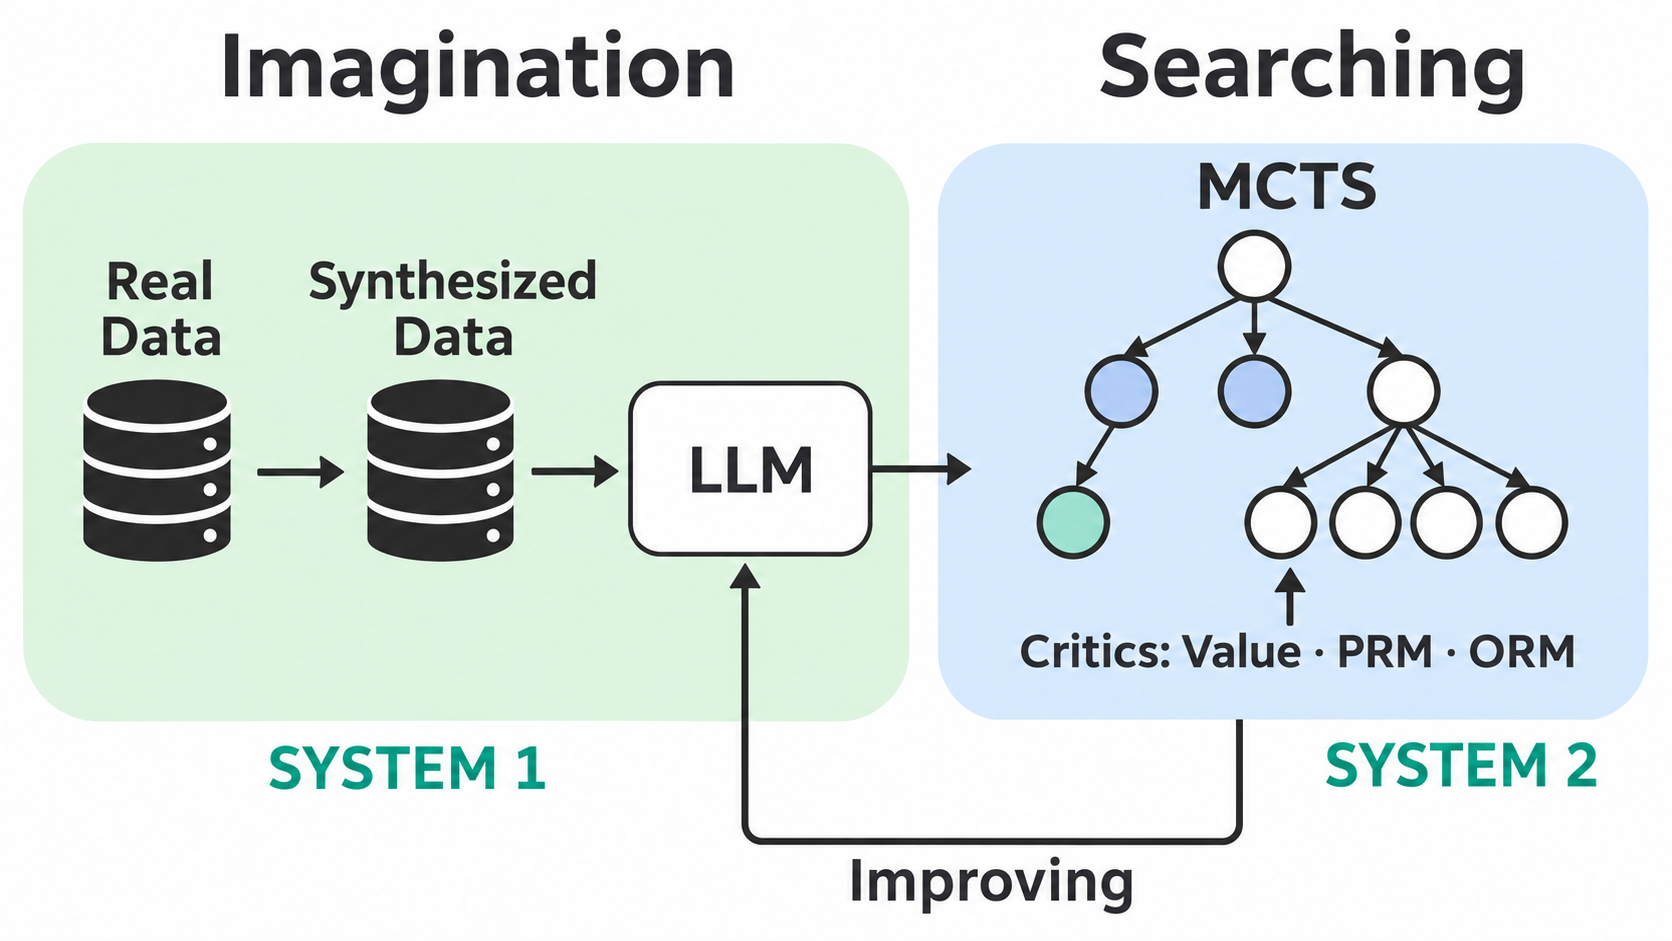
AlphaLLM:LLM 推理与自进化
Tencent AI Lab
提出面向 LLM 的自进化框架,结合问题合成、自训练、MCTS 和多 critic 评价,通过搜索与反馈迭代提升数学推理能力。在论文评测中,结合树搜索的模型取得了与同期 GPT-4 相当的结果。发表于 NeurIPS 2024,并于 2024 年 4 月 19 日位列 Hugging Face Daily Papers 日榜 #1。
-
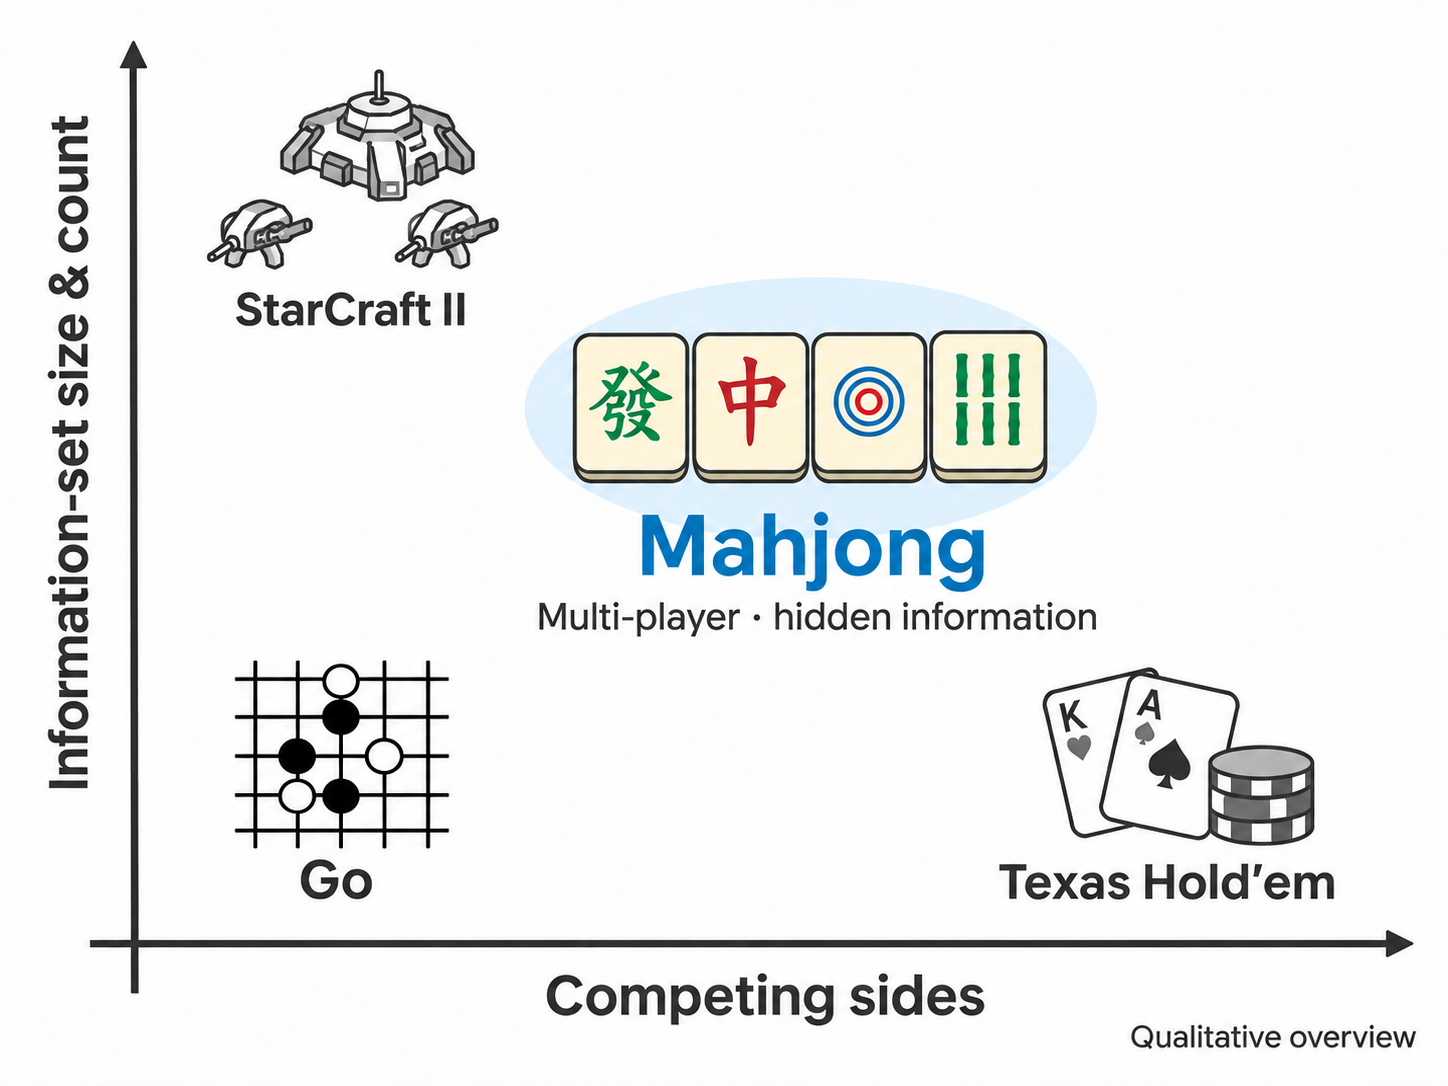
腾讯绝艺(LuckyJ):大规模自博弈与多智能体 RL
Tencent AI Lab (AIPD)
围绕不完全信息博弈开展大规模自博弈强化学习,训练腾讯麻将 AI LuckyJ。系统在有世界冠军参加的职业选手评测中取得领先成绩,并于 2023 年创下当时天凤特上桌的最高稳定段位纪录。
在对手建模与稳健决策方面,提出 GSCU,通过对手策略表征、在线后验推断与策略切换,应对未知及非平稳对手。该工作发表于 ICML 2022(Spotlight)。
代表性论文
-
FLARE: A Failure-Aware Framework for Autonomous Correction and Recovery in Visual-Language Robotic Manipulation
CVPR 2026.
-
ProAct: A Benchmark and Multimodal Framework for Structure-Aware Proactive Response
ICML 2026.
-
Iterative Nash Policy Optimization: Aligning LLMs with General Preferences via No-Regret Learning
ICLR 2025 (Oral).
-
Multi-Agent Collaboration via Evolving Orchestration
NeurIPS 2025. [Code]
-
LiteSearch: Efficient Tree Search with Dynamic Exploration Budget for Math Reasoning
AAAI 2025.
-
TAIROS: An Embodied AI Platform for Robotics Applications
Technical report, 2025.
-
Toward Self-Improvement of LLMs via Imagination, Searching, and Criticizing
NeurIPS 2024. [Code]
-
Greedy when Sure and Conservative when Uncertain about the Opponents
ICML 2022 (Spotlight). [Code]